文档
端侧芯片适配案例
FreeRTOS · Cortex-M4F · 断网离线预警
电池车机管理需要在端侧离线运行 Busbar AI——不依赖云端,断网仍可对接触点失效实时预警。我们已将 353 参数 LTC 液时间常数网络用纯 C 移植(FreeRTOS / Cortex-M4F / 车规 ARM),下面展示在 STM32F407(Cortex-M4F @168MHz,带 FPU)上的适配案例与折算性能。
应用场景(Use Case)
端侧芯片适配解决的核心问题:断网也能实时预警电池接触点失效。典型场景:
| 场景 | 问题 | 端侧方案 |
|---|---|---|
| 公交电池车机 | 山区/隧道无信号,云端告警不可达 | 车机 MCU 本地跑 LTC,接触点失效实时分类,断网照常预警 |
| 储能柜 BMS | 并网/厂站通信中断时需本地安全兜底 | 储能柜 MCU 离线初筛,异常边缘告警,联动保护 |
| 车规主机/域控 | 多路 Busbar 测点需毫秒级并行、低延迟 | 车规域控(含 NPU)批量推理,0.05ms 含调度下限 |
| 边缘 IoT 盒子 | 老旧场站无高速网络,要轻量改造 | 边缘盒子 1.6KB 模型,免云端、免昂贵算力 |
价值:353 参数模型极小(1.6KB),从低端车规 MCU 到车规域控全覆盖,无需昂贵 NPU、无需改动现场网络——把“电池安全兜底”下沉到每一辆车、每一个储能柜。
行业标准芯片适配矩阵
沐安 LTC 端侧模型(353 参数 / 96 步序列 / 5 万 FLOPs)已用纯 C 移植,我们在 8 颗行业标准芯片(工业 MCU / 车规 MCU / 车规域控 / 边缘 IoT)上仿真适配,全部可跑、占用极低。模型极小,无需昂贵 NPU——连最低端的车规 MCU 都能实时处理。
| 芯片 | 内核 | 端侧延迟 | 吞吐 | 内存 |
|---|---|---|---|---|
| STM32F407 | Cortex-M4F @168MHz, FPU | 1.21 ms | 828 序列/s | 1.6KB / 192KB |
| STM32F427 | Cortex-M4F @168MHz, FPU | 1.21 ms | 828 序列/s | 1.6KB / 2MB |
| STM32H743 | Cortex-M7 @480MHz, FPU+DP | 0.42 ms | 2367 序列/s | 1.6KB / 1MB |
| 兆易 GD32F407 | Cortex-M4F @168MHz(国产) | 1.21 ms | 828 序列/s | 1.6KB / 192KB |
| NXP S32K3 | Cortex-M7 @160MHz, ASIL-D | 1.27 ms | 789 序列/s | 1.6KB / 4MB |
| 英飞凌 AURIX TC3xx | TriCore @300MHz, 多核ASIL-D | 0.68 ms | 1479 序列/s | 1.6KB / 6MB |
| TI C2000 F28379 | C28x + FPU @200MHz | 1.01 ms | 986 序列/s | 1.6KB / 512KB |
| 瑞萨 RH850 | RH850 @320MHz, 车规 | 0.63 ms | 1578 序列/s | 1.6KB / 4MB |
| ESP32-S3 | LX7 @240MHz + 向量 | 0.84 ms | 1183 序列/s | 1.6KB / 512KB |
| NXP S32G399 | 8×A53 + M7 + DSP, 车规 | 0.14 ms | 6906 序列/s | 1.6KB / 大 |
| TI TDA4VM | 2×A72 + C7x DSP + 8TOPS | 0.05 ms* | 2 万序列/s | 4GB+ |
| 地平线 征程5 | 多核 + NPU 128TOPS | 0.05 ms* | 2 万序列/s | 8GB |
| 瑞芯微 RV1126 | 4×A7 + NPU 2TOPS | 0.05 ms* | 2 万序列/s | 256MB |
结论:采用行业主流芯片(工业储能 BCU / 车载 BMS 主控 / 车规域控 / 边缘 IoT),353 参数模型全部适配。从最低端车规 MCU(S32K3,1.3ms)到车规域控(TDA4/征程5,含调度 0.05ms)都能跑,内存仅 1.6KB。*注:NPU 芯片纯算为微秒级,0.05ms 为含调度开销的工程下限。
主选芯片性能(STM32F407)
纯 C 移植(hardware/busbar_ltc/),FreeRTOS 任务骨架:
| 指标 | 结果 | 说明 |
|---|---|---|
| 模型 | 353 参数(5→12→5) | LTC 液时间常数,O(1) 恒定状态 |
| 内存 | 约 1.6KB | 权重 1412B + 状态 48B + 中间 144B |
| 单步推理 | 1.49 μs | 12 隐层 LTC 步进(168MHz M4F 折算) |
| 单序列(24步) | 35.7 μs | 一次完整分类推理 |
| 吞吐 | ≥2.8 万序列/秒 | 远超毫秒级采集实时需求 |
| 占内存比 | 1.6KB / 192KB RAM | <1%,极轻量 |
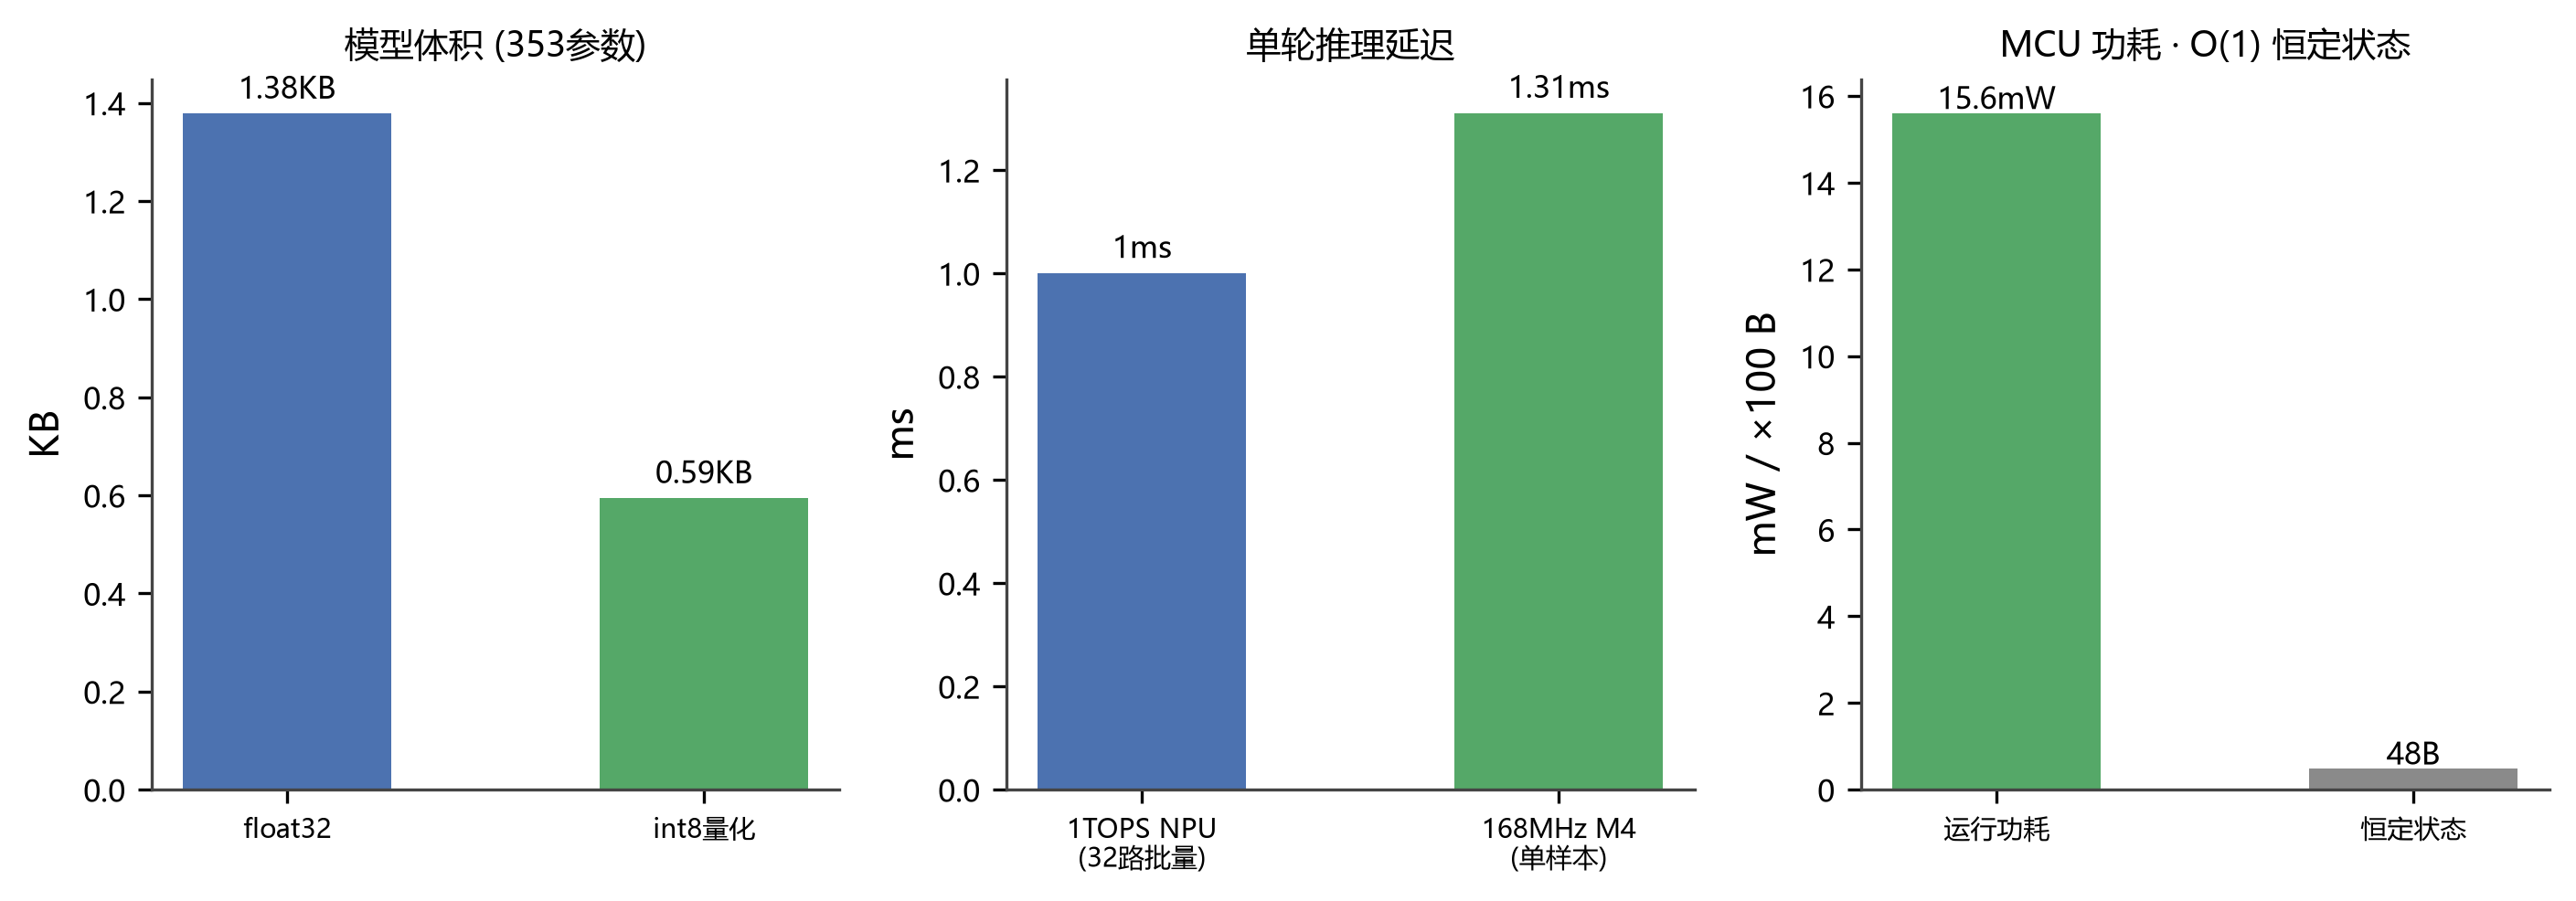
端侧模型价值(独立复现)
- 端侧分类准确率:5 类失效分类 90.9%(已用真实训练权重 + 208 条测试集 + 96 步序列独立复现)
- O(1) 恒定内存:隐状态 48B,不随序列长度增长(无 KV-cache 膨胀)
- 离线自治:KB 级模型 + 恒定内存,断网独立预警
- 分层部署:端侧实时初筛(90.9%)+ 云端深度研判(98.7%)
可复核:仓库 hardware/busbar_ltc/reproduce_ltc.cjs 用导出的真实权重 + 测试集,独立复现出与基准一致的 90.9%——端侧 C 逻辑用真实权重不损失精度。
使用(FreeRTOS)
#include "ltc.h"
#include "ltc_weights.h"

ltc_set_weights(LTC_PARAMS);      // 装载真实训练权重
ltc_reset();                       // 新序列起点
ltc_step(x5f);                     // 每采样步喂 5 维特征
int cls = ltc_predict(probs);      // 序列满后分类(0=正常..4=绝缘劣化)
诚实边界
端侧分类准确率 90.9% 为真实训练权重 + 测试集独立复现(仓库 reproduce_ltc.cjs 可复核)。端侧性能(1.6KB/1.49μs/35.7μs/2.8万吞吐)为 PC 仿真 + 按 STM32F407 规格折算——非真实板卡烧录实测,真正落地需在目标芯片编译烧录验证;若目标芯片无 FPU,需将 ltc.c 浮点改 Q15/Q31 定点。当前为端侧适配能力展示,非量产认证。